
Künstliche Intelligenz kann heute beeindruckend gut mit Dokumenten umgehen. PDFs lesen, Inhalte zusammenfassen, strukturierte Daten extrahieren, Texte analysieren oder aus unübersichtlichen Informationen klare Resultate erzeugen.
Zumindest in der Demo.
In der Praxis stellt sich aber schnell eine andere Frage:
Wie zuverlässig funktioniert das wirklich mit echten Dokumenten, echten Anforderungen und echten Prozessen?
Genau diese Frage hat uns bei imatics beschäftigt.
Denn wenn KI nicht nur ausprobiert, sondern produktiv eingesetzt werden soll, reicht ein gutes Einzelresultat nicht aus. Dann braucht es Vergleichbarkeit, Messbarkeit und ein klares Verständnis dafür, welches Modell für welchen Zweck wirklich geeignet ist.
Der Auslöser: Zeugnis-Pro
Ein konkreter Auslöser war die Entwicklung von Zeugnis-Pro, einem eigenen imatics Produkt.
Dabei sollen hochgeladene PDF-Dokumente zuerst zuverlässig in Text umgewandelt und anschliessend analysiert werden. Auf den ersten Blick klingt das einfach. In der Praxis hängt aber sehr viel davon ab, wie gut die einzelnen Schritte funktionieren.
- Wird der Text korrekt erkannt?
- Bleiben wichtige Inhalte erhalten?
- Versteht das Modell den Kontext richtig?
- Kommt eine stabile und verarbeitbare Antwort zurück?
- Wie schnell ist die Verarbeitung?
- Was kostet ein einzelner Lauf?
- Und welche Variante ist aus Datenschutzsicht sinnvoll?
Schnell wurde klar: Ein einzelner Test mit einem PDF sagt wenig aus.
Ein Modell kann bei einem Dokument sehr gut funktionieren und bei einem anderen plötzlich Fehler machen. Ein anderes Modell ist vielleicht langsamer, dafür günstiger. Ein lokales Modell kann aus Datenschutzsicht spannend sein, liefert aber je nach Dokumenttyp andere Resultate als eine Cloud-API.
Deshalb haben wir begonnen, KI-Modelle systematisch zu vergleichen.
Warum Bauchgefühl nicht reicht
Viele AI Use Cases starten mit einem einfachen Test:
Man lädt ein Dokument hoch, stellt eine Frage und erhält eine Antwort. Wenn diese Antwort gut aussieht, entsteht schnell der Eindruck, dass der Use Case funktioniert.
Das Problem: Eine plausible Antwort ist nicht automatisch eine korrekte Antwort.
Gerade bei Dokumentenprozessen können kleine Fehler grosse Auswirkungen haben. Ein falscher Betrag, ein fehlendes Datum, eine falsch erkannte Person oder eine unvollständige Zusammenfassung können dazu führen, dass ein nachgelagerter Prozess nicht sauber funktioniert.
Deshalb reicht es nicht, zu fragen: Sieht das Ergebnis gut aus?
Die wichtigere Frage lautet:
Ist das Ergebnis messbar korrekt, stabil und wirtschaftlich sinnvoll?
Unser interner Benchmarking-Ansatz
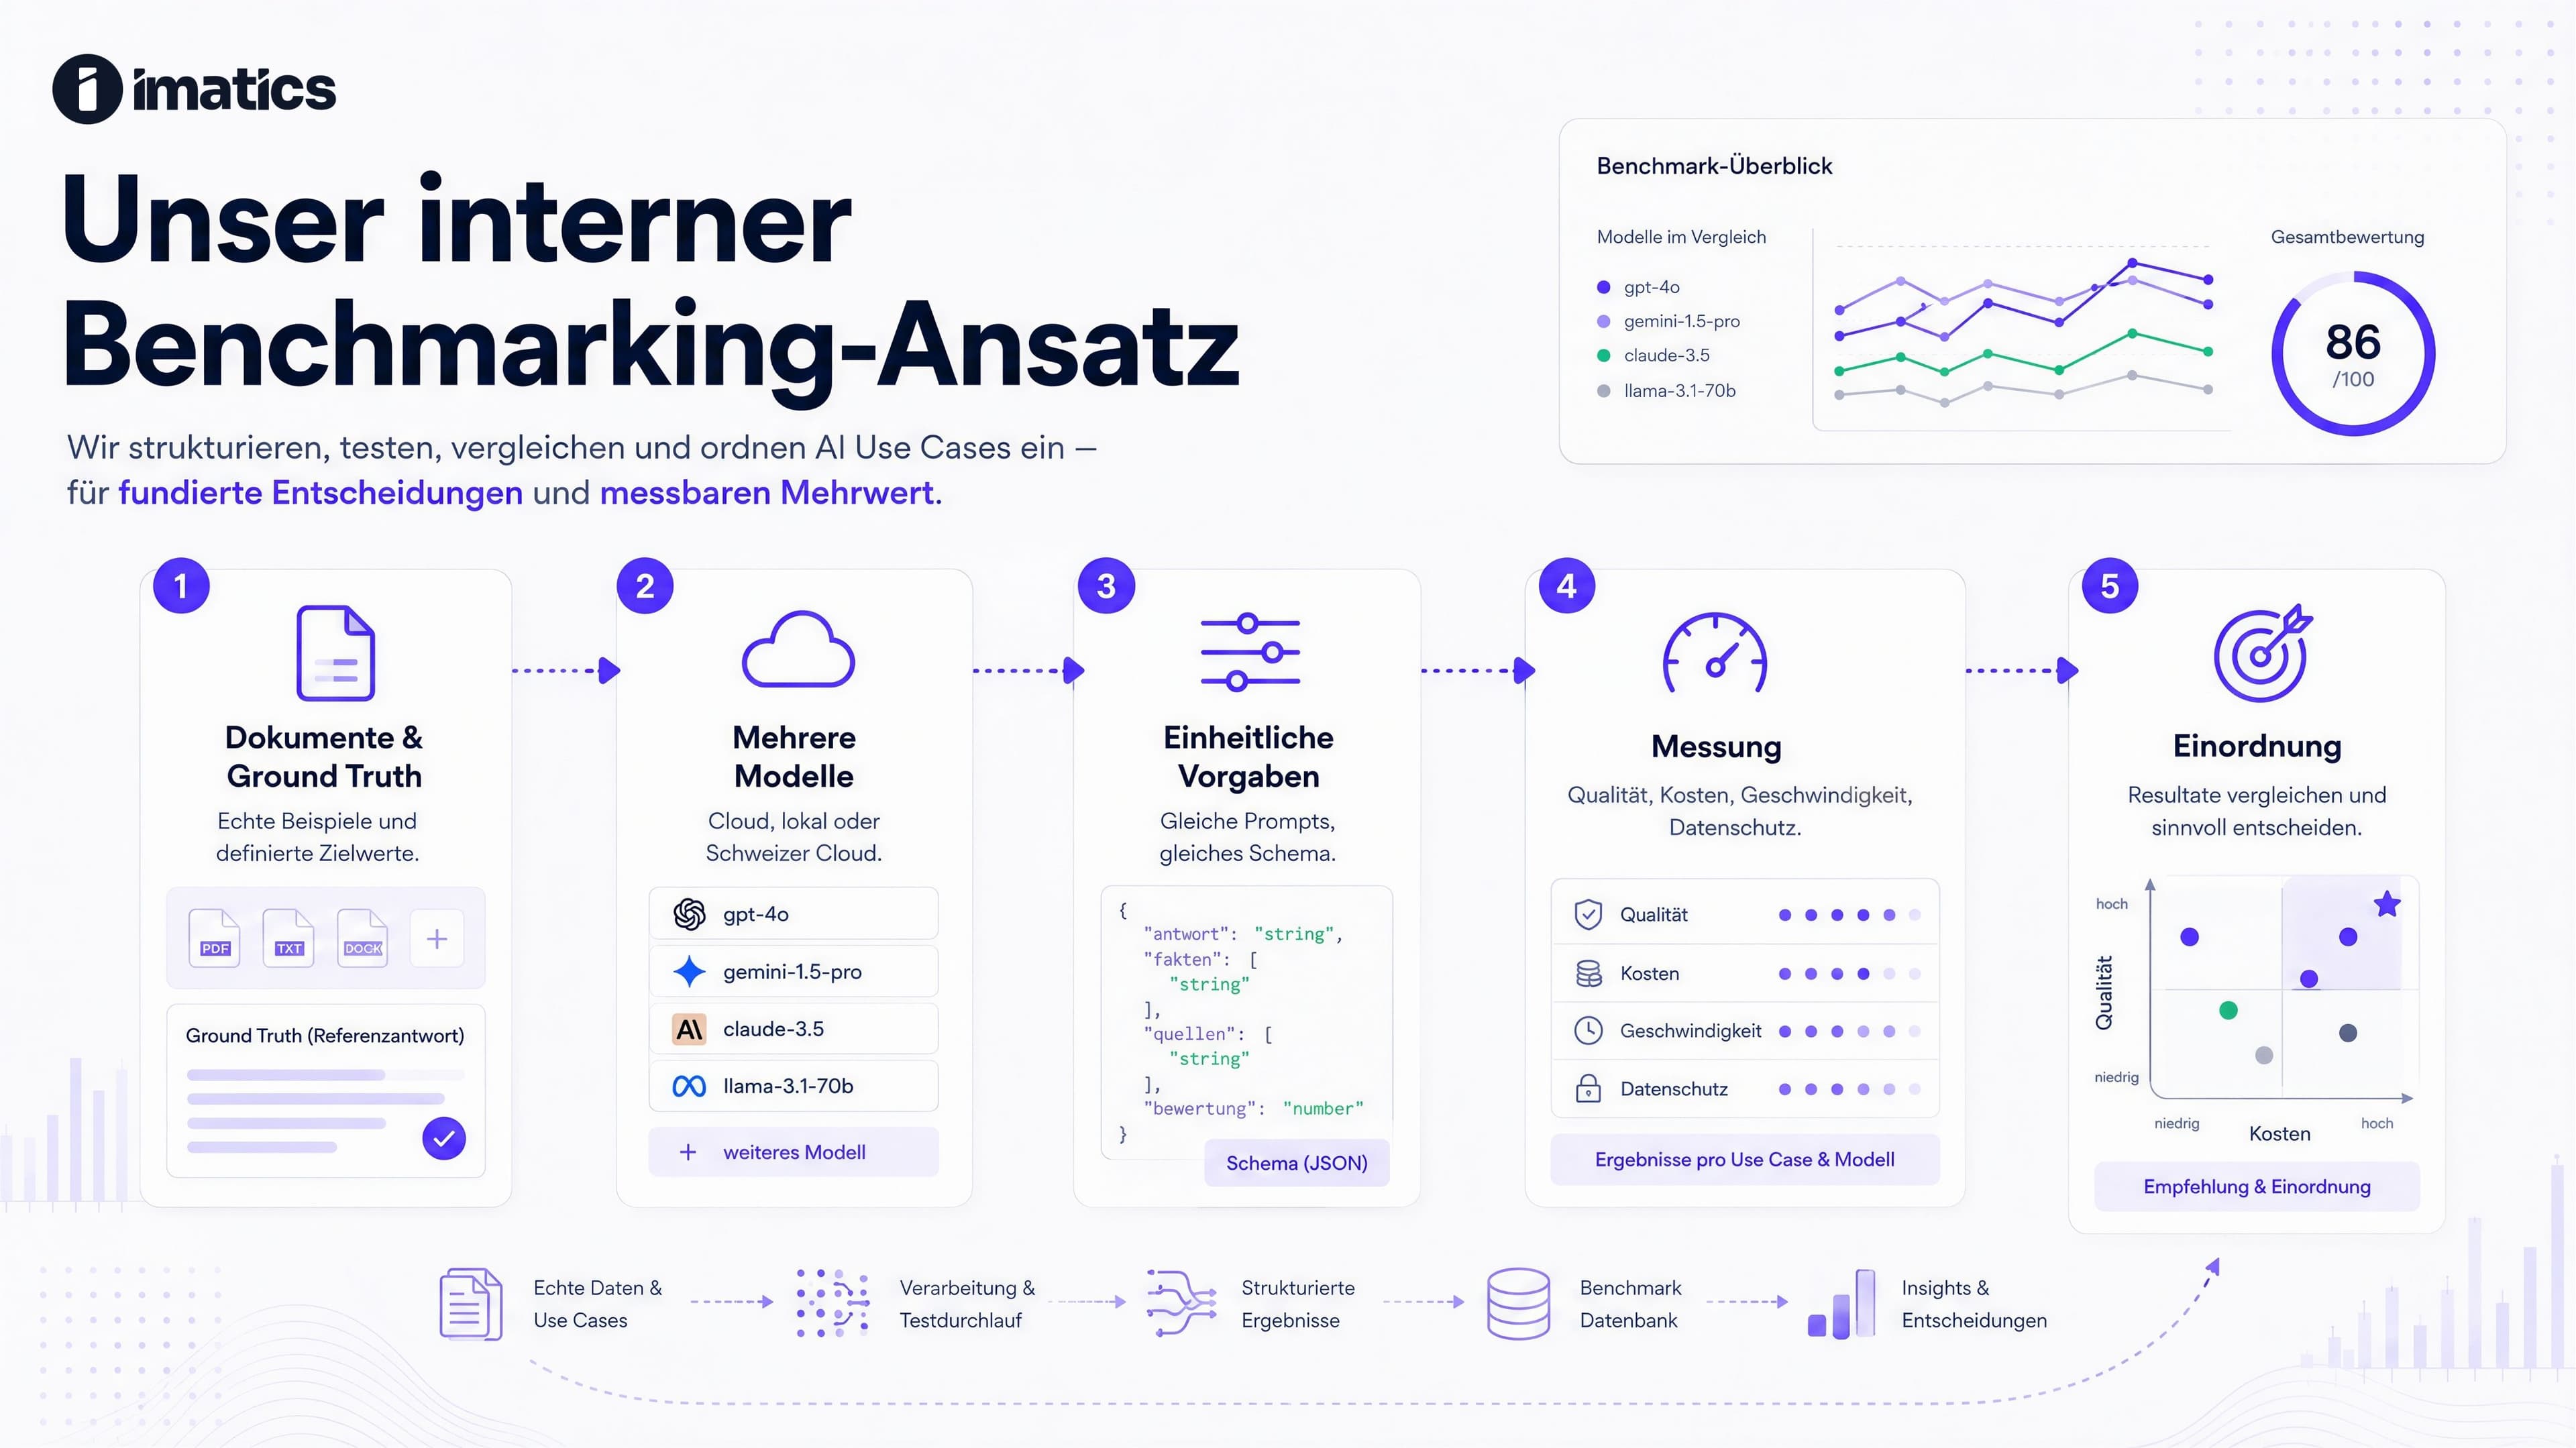
Bei imatics ist daraus ein internes Benchmarking-Setup entstanden. Es hilft uns, verschiedene Modelle und Ansätze anhand echter Beispiele zu vergleichen. Dabei geht es nicht darum, pauschal das «beste» KI-Modell zu finden. Dieses Modell gibt es so nicht.
Es geht darum, das passende Modell für einen konkreten Anwendungsfall zu finden.
Wir betrachten dabei unter anderem folgende Kriterien:
Genauigkeit
Wie gut stimmen die extrahierten oder analysierten Inhalte mit den erwarteten Resultaten überein?
Strukturierte Ausgabe
Kann das Modell die Antwort in einem klar definierten Format liefern, zum Beispiel als JSON?
Schema-Konformität
Hält sich die Antwort an die vorgegebene Struktur oder entstehen Fehler, die eine Weiterverarbeitung erschweren?
Geschwindigkeit
Wie lange dauert die Verarbeitung? Wie schnell kommt die erste Antwort? Wie verhält sich das Modell bei mehreren Dokumenten?
Tokenverbrauch und Kosten
Wie viel kostet ein Lauf ungefähr? Wie entwickeln sich die Kosten, wenn aus einem Test ein regelmässiger Prozess wird?
Datenschutz und Betriebsmodell
Ist eine Cloud-API sinnvoll? Kommt eine Schweizer Cloud in Frage? Oder braucht es ein lokales Modell, das innerhalb der eigenen Umgebung läuft?
Besonders relevant für kleine KMU
imatics fokussiert bewusst auf kleinere KMU – typischerweise Teams von 1 bis 15 Personen. Dazu gehören zum Beispiel Büros, Arztpraxen, lokale Dienstleister oder kleine Fachbetriebe.
Gerade dort ist der Bedarf oft sehr konkret:
- Ein Formular soll schneller verarbeitet werden.
- Ein PDF soll automatisch zusammengefasst werden.
- Ein wiederkehrender administrativer Ablauf soll weniger Zeit kosten.
- Ein Dokument soll in eine klare Struktur gebracht werden.
- Ein AI Use Case soll zuerst verständlich geprüft werden, bevor investiert wird.
Für solche Unternehmen geht es selten um grosse Enterprise-Projekte. Es geht darum, pragmatisch herauszufinden, was mit KI realistisch möglich ist, wo die Grenzen liegen und ob sich eine Automatisierung wirklich lohnt.
Genau hier hilft ein sauberer Benchmark.
Nicht als kompliziertes Forschungsprojekt. Sondern als praktische Entscheidungsgrundlage.
Was ein guter Benchmark sichtbar macht
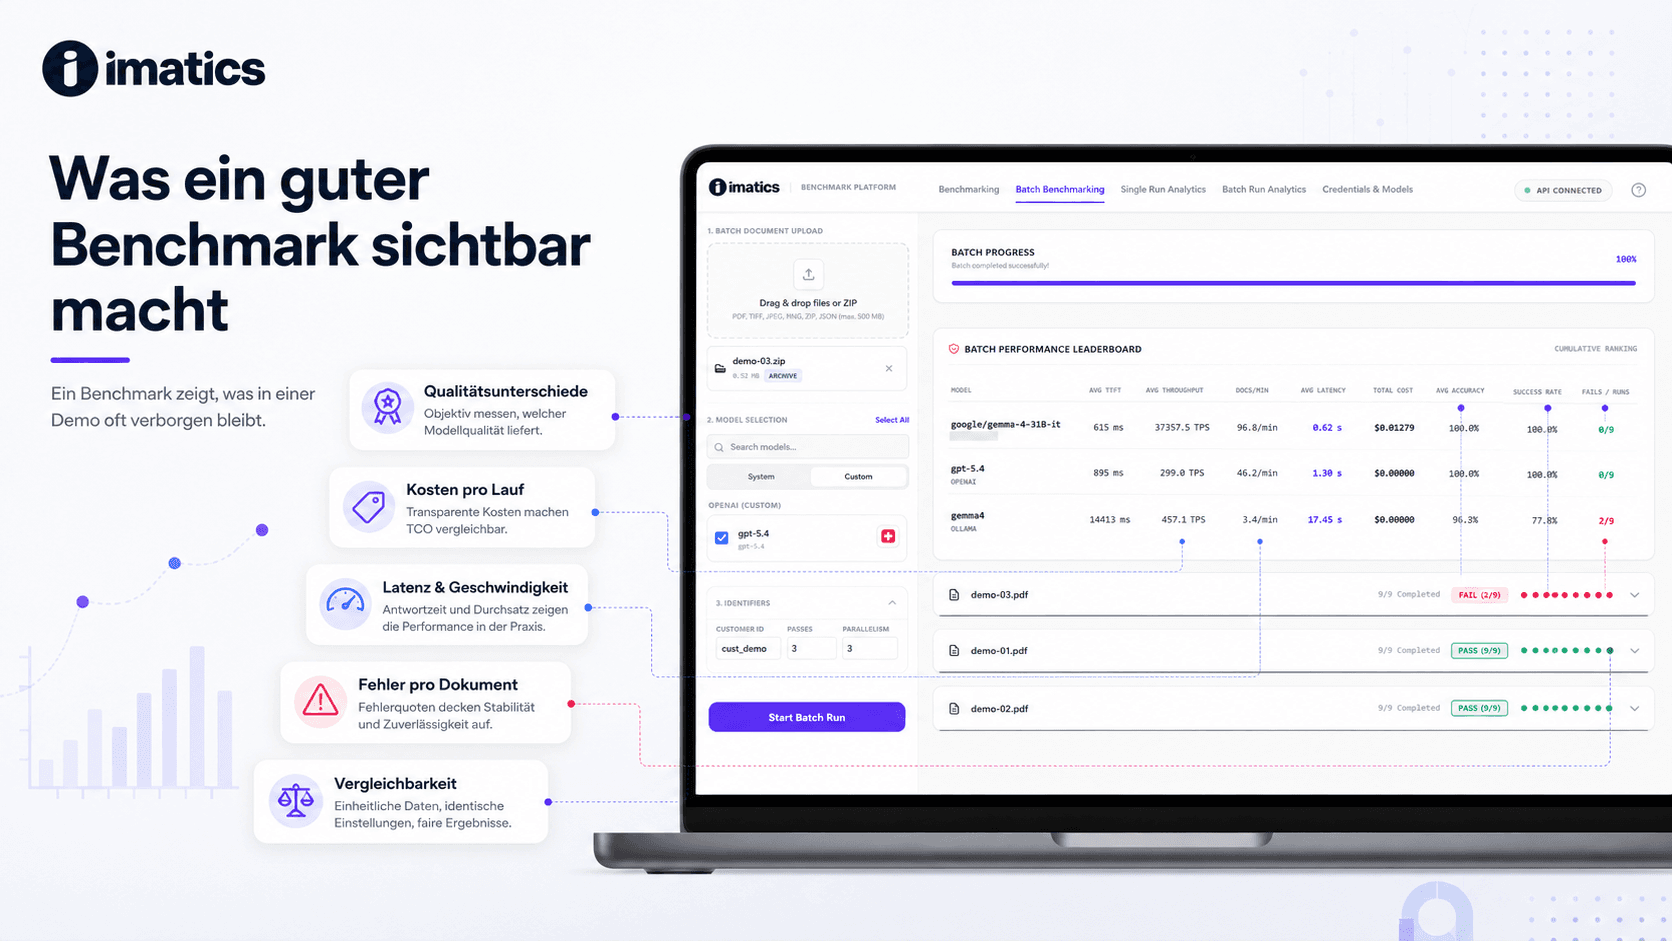
Ein Benchmark zeigt oft Dinge, die in einer Demo unsichtbar bleiben.
Zum Beispiel:
- Ein Modell ist sehr schnell, macht aber bei bestimmten Feldern wiederholt Fehler.
- Ein anderes Modell ist genauer, aber deutlich teurer.
- Ein lokales Modell ist aus Datenschutzsicht attraktiv, braucht aber mehr technische Abstimmung.
- Eine Cloud-API liefert starke Resultate, ist aber nicht für jeden Dokumenttyp wirtschaftlich.
- Ein Prompt funktioniert bei einem Dokument gut, bei zehn ähnlichen Dokumenten aber nicht stabil genug.
Solche Erkenntnisse sind wertvoll, bevor ein AI Use Case produktiv umgesetzt wird. Denn sie helfen, Fehlentscheide zu vermeiden.
Unser Fazit
KI in Dokumentenprozessen sollte nicht nur beeindruckend aussehen. Sie muss im Alltag funktionieren. Dazu braucht es einen klaren Blick auf Qualität, Kosten, Datenschutz und technische Machbarkeit.
Unser bisheriges Fazit ist deshalb einfach:
Das beste Modell gibt es nicht pauschal. Es gibt nur das passende Modell für einen konkreten Dokumenttyp, einen konkreten Prozess und konkrete Rahmenbedingungen.
Mit imatics möchten wir genau solche Fragen greifbar machen – besonders für kleinere KMU, die AI Use Cases pragmatisch prüfen und sinnvoll einordnen möchten.
KMU Use Case oder Enterprise-Dokumentenprozess?
Ob kleiner KMU-Use-Case oder komplexerer Enterprise-Dokumentenprozess: Wichtig ist, früh sauber zu verstehen, was wirklich gebraucht wird.
Verstehen, testen, messen – und erst dann entscheiden.